Deux intitulés, deux marchés, deux niveaux de négociation. Beaucoup de freelances utilisent les deux termes indifféremment sur leur profil, et perdent sur les deux tableaux : trop généraliste pour les missions DataOps, trop vague pour les missions de développement de pipelines.
Cet article clarifie la frontière réelle entre les deux, et aide à choisir le positionnement qui correspond à votre expérience.
Data Engineer et DataOps : quelle différence ?
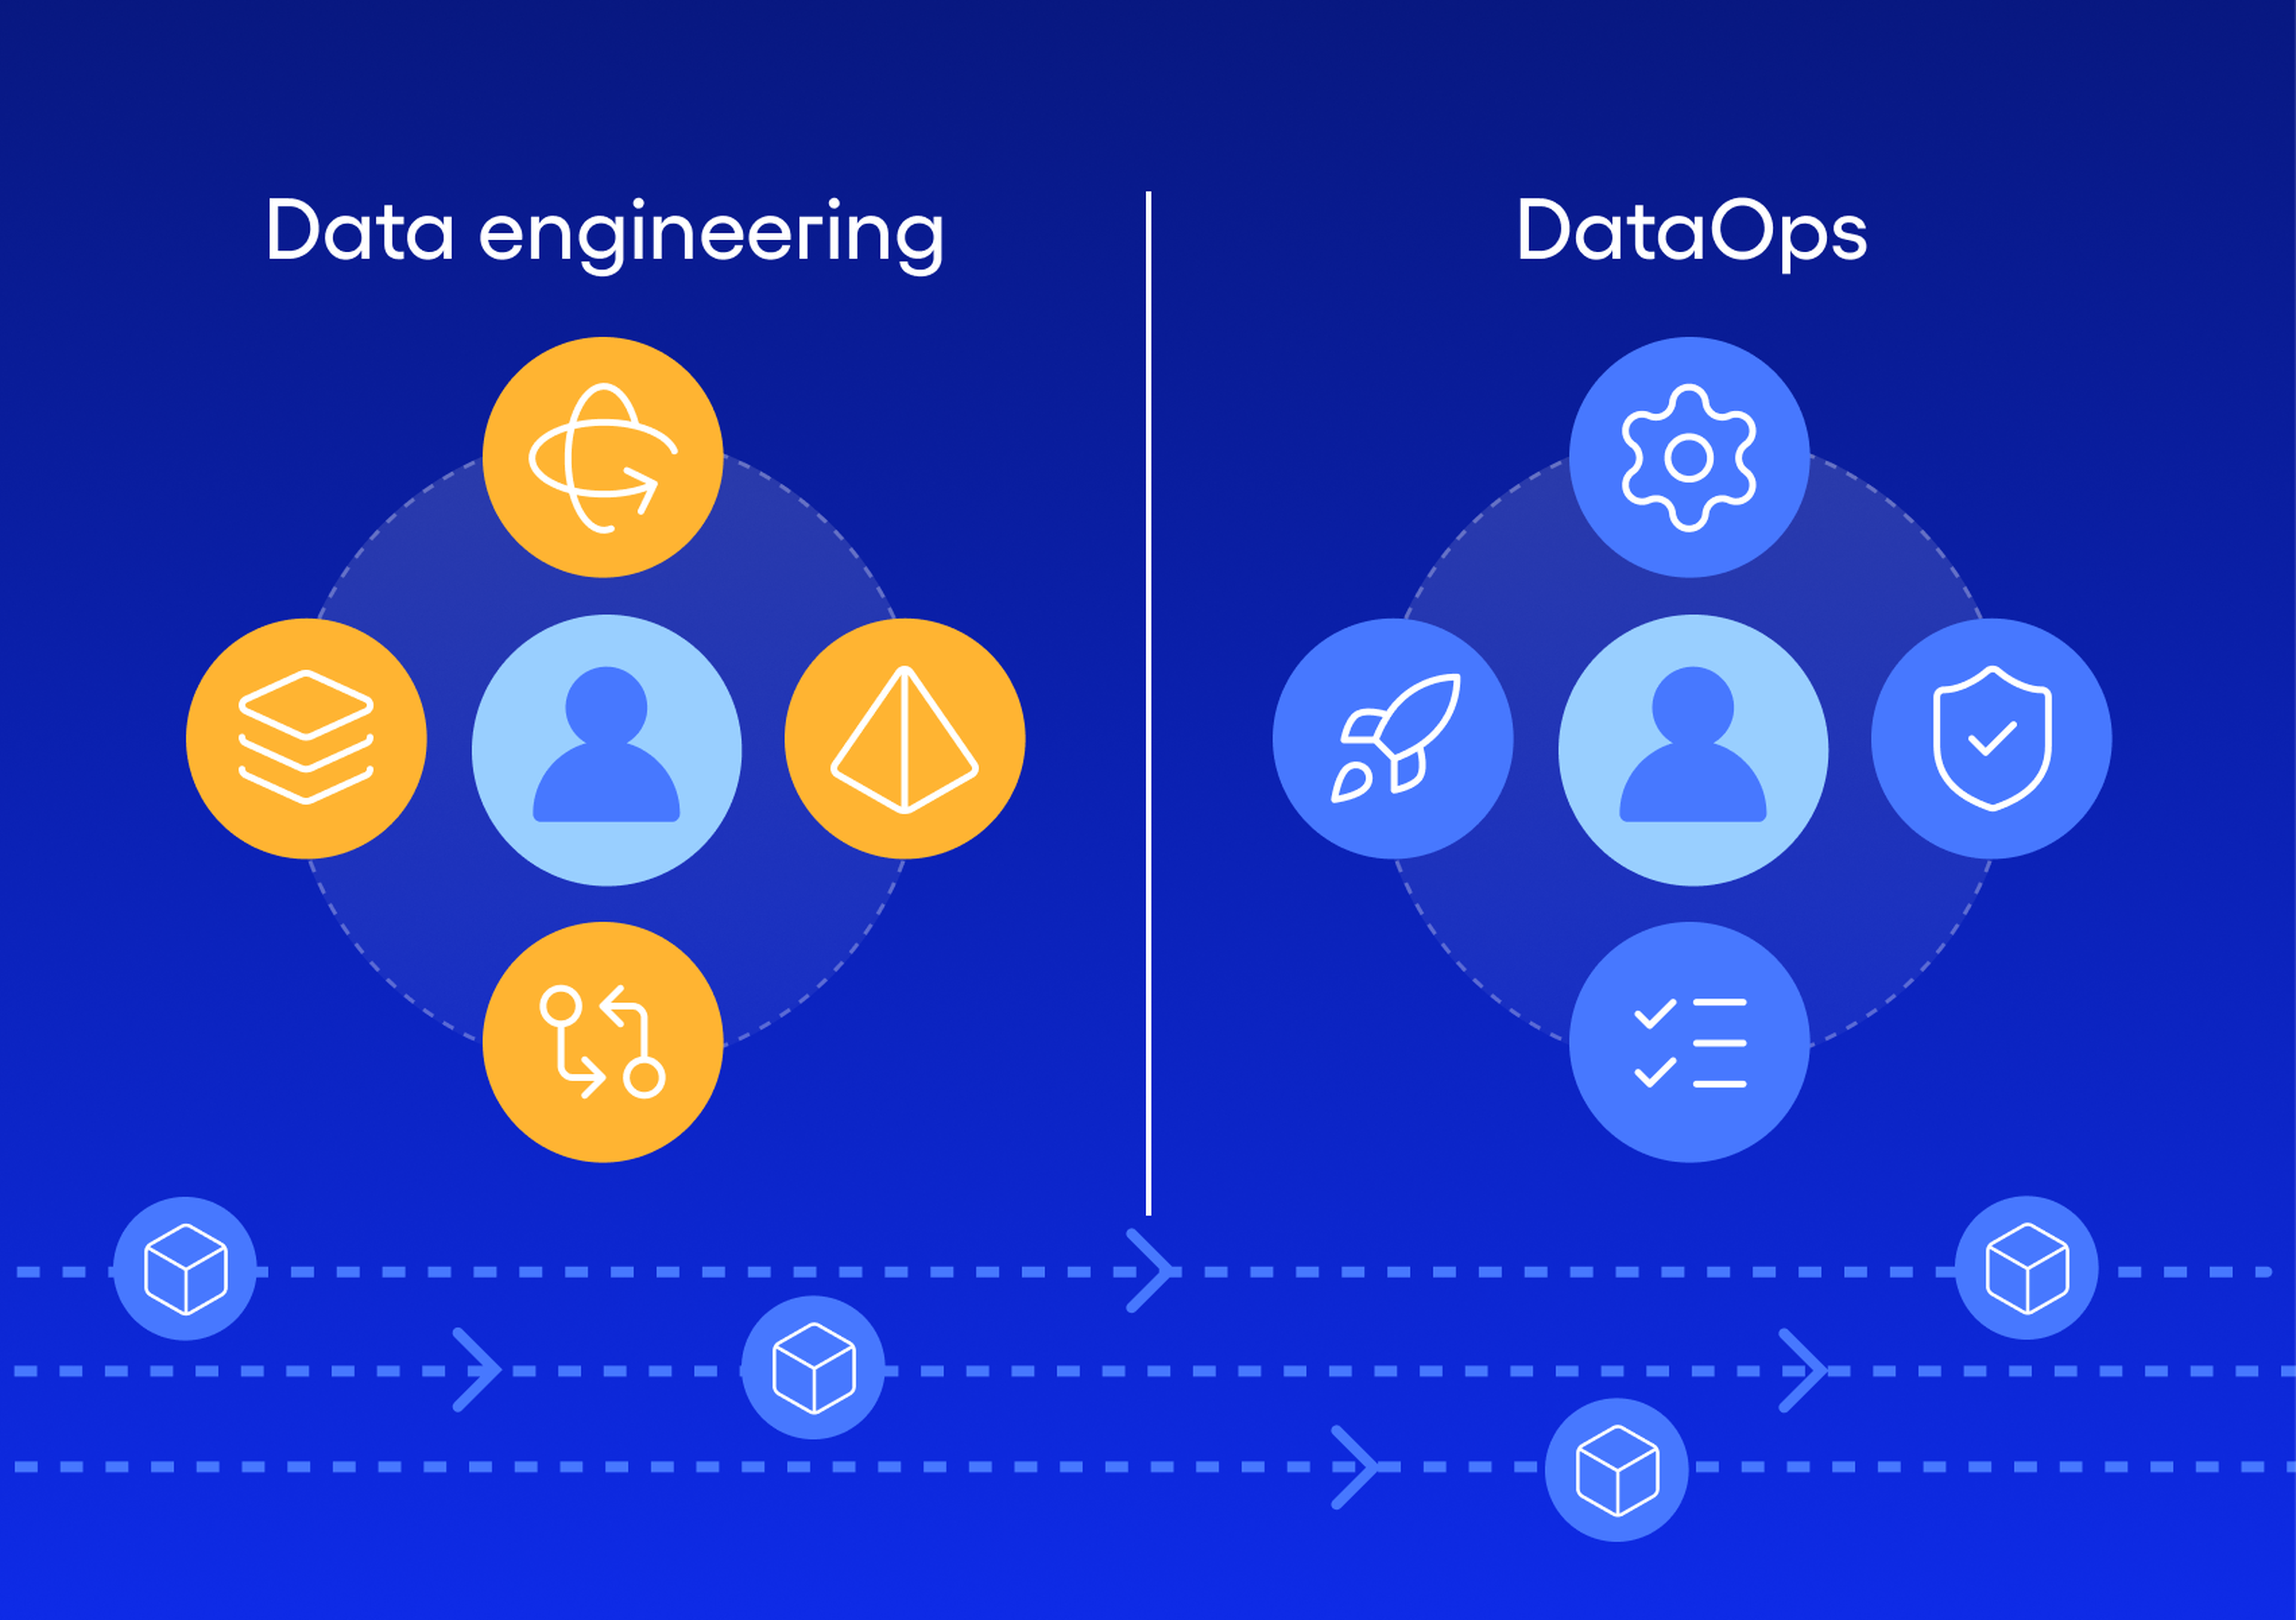
Le Data Engineer conçoit les flux qui collectent, transforment et rendent les données disponibles. Son périmètre peut couvrir l’architecture, l’ingestion, la modélisation et l’orchestration des traitements.
Le DataOps applique aux données des pratiques issues du DevOps. Il s’intéresse à la façon dont les flux sont testés, déployés, surveillés et maintenus. DataOps ne remplace donc pas le Data Engineering : il contribue à mieux industrialiser son cycle de production, comme l’explique dbt Labs dans son analyse des deux disciplines.
La distinction consiste à regarder ce que le client attend. S’agit-il de construire un flux ou faut-il aussi garantir son fonctionnement en production ?
En une phrase
Le Data Engineer construit et fait évoluer les flux. Le DataOps ajoute une logique d’industrialisation, de contrôle et de supervision. Une même personne peut donc exercer les deux périmètres, selon l’organisation et la mission.
| Critère | Data Engineer | DataOps |
|---|---|---|
Objet principal | Flux, modèles et architecture | Chaîne de production et fonctionnement dans la durée |
Responsabilités | Ingestion, transformation, modélisation | Automatisation, tests, déploiement, supervision |
Livrable | Pipeline ou modèle répondant à un besoin métier | Chaîne testée, observable et maintenable |
Preuves attendues | Choix d’architecture, qualité et performance | Fiabilité, gestion des changements et incidents |
Les compétences qui font la différence
La maîtrise d’un outil ne suffit pas à caractériser un profil DataOps. Ce qui compte, c’est la capacité à expliquer comment une chaîne est contrôlée avant sa mise en production, comment elle est surveillée ensuite et comment l’équipe réagit lorsqu’un traitement échoue.
| Compétence | Positionnement concerné | Preuve à présenter |
|---|---|---|
Modélisation de données | Data Engineer | Un modèle conçu, les choix retenus et leur lien avec le besoin métier |
Transformation et performance | Data Engineer | Une optimisation de requête ou de pipeline, avec un gain mesuré lorsque cette donnée est disponible |
Tests de données | Les deux | Les contrôles mis en place et le comportement prévu en cas d’échec |
Intégration continue et déploiement continu (CI/CD) | DataOps | Le fonctionnement de la chaîne de validation et les règles qui empêchent un déploiement incorrect |
Gestion des environnements | DataOps | La stratégie de promotion entre développement, test et production |
Observabilité des flux | DataOps | Les indicateurs suivis, les seuils d’alerte et les personnes qui reçoivent les notifications |
Gestion d’incident | DataOps | Un incident décrit avec sa détection, son diagnostic, sa correction et les mesures prises ensuite |
Comment choisir son positionnement freelance ?
Choisissez Data Engineer si votre expérience porte principalement sur la construction de pipelines, la connexion de sources, la transformation et la modélisation. Votre profil doit expliquer les besoins métiers servis, les arbitrages techniques et les résultats obtenus.
Choisissez DataOps si vous avez aussi travaillé sur le cycle de vie complet des flux : tests, environnements, déploiements, supervision et résolution d’incidents. L’astreinte peut faire partie de certaines missions, mais elle n’est pas obligatoire. Une expérience concrète de production suffit déjà à démontrer votre capacité à fiabiliser une chaîne.
La valorisation dépend du périmètre, de la criticité des flux, de l’expérience et des responsabilités prises. Un profil DataOps peut être mieux valorisé lorsqu’il assume une responsabilité de production clairement démontrée, mais l’intitulé seul ne suffit pas.
Peut-on utiliser les deux intitulés ?
Oui, à condition de hiérarchiser le message. Préférez : Data Engineer, pratique DataOps : tests, CI/CD et observabilité à « Data Engineer / DataOps ». Le premier intitulé indique votre cœur de métier et le complément précise votre périmètre.
Cette règle vaut pour votre CV comme pour votre profil LinkedIn. Le lecteur doit comprendre rapidement ce que vous construisez, ce que vous exploitez et sur quels types de missions vous pouvez intervenir. Pour travailler la visibilité de votre profil, consultez cet article sur LinkedIn et le positionnement freelance.
Les erreurs de positionnement à éviter
Cumuler les deux intitulés sans expliquer le périmètre rend le profil difficile à lire. Présentez votre activité principale, puis les pratiques complémentaires que vous maîtrisez.
Évitez aussi de revendiquer DataOps sans preuve d’exploitation. Si votre expérience est encore centrée sur la construction, écrivez plutôt : Data Engineer, avec une pratique de l’automatisation et des tests. Cette formulation reste précise et défendable.
Enfin, ne réduisez pas votre profil à une liste d’outils. Un pipeline sert un reporting, une application, un modèle d’intelligence artificielle ou une décision opérationnelle. Expliquez l’usage rendu possible et les contraintes prises en compte.
Quelles preuves présenter en entretien ?
Un intitulé ne remplace pas une démonstration. Préparez deux ou trois situations professionnelles avec le contexte, votre intervention, la difficulté rencontrée et le résultat obtenu. Les compétences suivantes sont particulièrement utiles pour différencier les deux positionnements :
Data Engineer : un modèle conçu, une source intégrée ou une optimisation de requête avec un gain mesuré lorsque cette donnée est disponible.
DataOps : une chaîne de validation, une stratégie de déploiement ou un incident traité en production.
Les deux : des tests de données et une explication claire du comportement prévu lorsqu’un contrôle échoue.
En entretien, vous devez notamment pouvoir répondre à ces questions :
Quel était votre dernier incident de pipeline et comment l’avez-vous corrigé ?
Qu’est-ce qui bloque un déploiement dans votre chaîne ?
Comment gérez-vous les jeux de données de test entre les environnements ?
Comment vérifiez-vous qu’un besoin métier a été correctement traduit ?
La documentation de dbt illustre cette approche : les changements peuvent être testés dans un environnement temporaire avant leur intégration en production.